
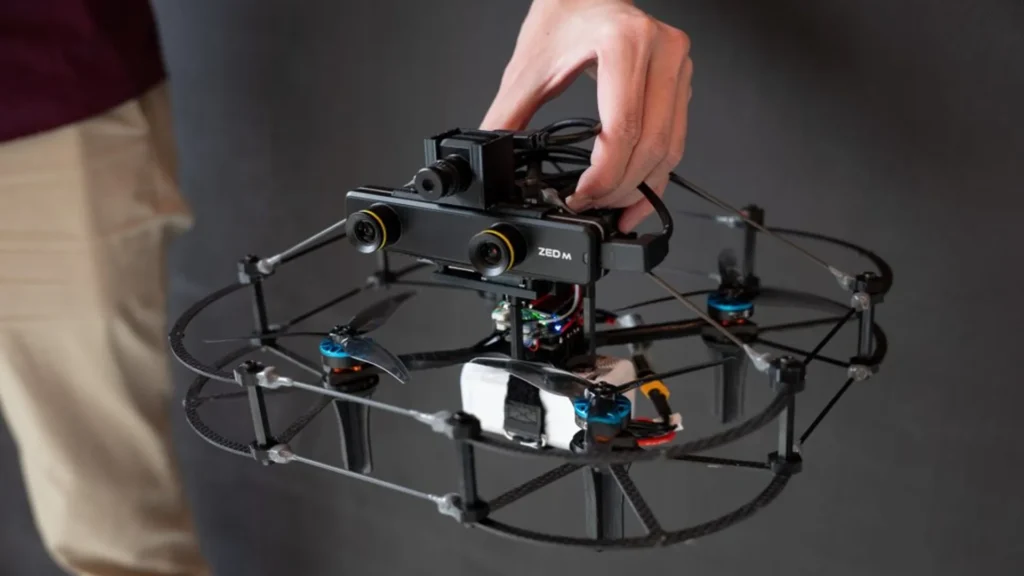
Des chercheurs américains ont développé un outil d’intelligence artificielle capable de traiter les données de vision robotique jusqu’à 440 fois par seconde, permettant potentiellement aux drones, véhicules autonomes et autres robots de réagir plus rapidement à leur environnement.
Développé par des ingénieurs de l’Université de Pennsylvanie, le système, appelé Fast Feature Field (F³), traite les informations des caméras événementielles, qui détectent les changements de lumière plutôt que de capturer des images conventionnelles.
Lors des tests, les algorithmes utilisant F³ ont fonctionné environ deux à cinq fois plus rapidement que les approches précédentes. Le système traitait les données haute définition des caméras d’événements 120 fois par seconde et atteignait 440 fois par seconde à une résolution VGA inférieure.
Les chercheurs affirment que cette technologie pourrait aider les robots à reconnaître les objets, à estimer les distances et à suivre les mouvements plus efficacement, en particulier dans des conditions d’éclairage difficiles.
Traiter des millions de signaux
Contrairement aux caméras conventionnelles qui capturent des images complètes à intervalles fixes, les caméras événementielles détectent en permanence les changements d’intensité lumineuse au niveau de pixels individuels.
Cela leur permet de capturer des mouvements rapides sans enregistrer des images entières. Cependant, l’interprétation de leurs résultats reste difficile car les caméras génèrent des millions de signaux individuels plutôt que des images reconnaissables.
Les approches existantes nécessitent généralement des algorithmes spécialisés pour différentes tâches, ce qui limite leur utilisation plus large en robotique.
Les chercheurs de Penn ont résolu ce problème en développant un réseau neuronal qui apprend à identifier des modèles utiles dans les données des caméras événementielles.
Au lieu de programmer le système séparément pour la reconnaissance d’objets, le suivi de mouvements ou l’estimation de distance, l’équipe a entraîné F³ à prédire les événements futurs en fonction des signaux précédents.
« Pour anticiper avec précision les événements futurs sur la base des événements passés, le réseau doit apprendre à représenter à la fois la structure d’une scène et le mouvement qui s’y déroule », a déclaré Richeek Das, le premier auteur de l’article.
Cette approche permet au système d’extraire des informations sur une scène et son mouvement sans nécessiter une méthode de traitement distincte pour chaque application.
Les chercheurs ont également trouvé un moyen de réduire les calculs inutiles.
Bien que les caméras événementielles puissent générer des dizaines de millions de signaux chaque seconde, environ 95 % des positions possibles dans les données ne contiennent aucun événement.
En traitant uniquement les emplacements où des changements se produisent, F³ évite de dépenser des ressources informatiques sur des zones vides. Cette optimisation a aidé les chercheurs à atteindre les vitesses de traitement nécessaires à la perception robotique en temps réel.
Tests sur plates-formes robotiques
L’équipe a évalué F³ à l’aide de données de caméras d’événements collectées à partir de voitures, de robots à quatre pattes et de drones volants.
Les tests comprenaient la reconnaissance d’objets, l’estimation de la distance et le suivi des mouvements dans des environnements allant des rues urbaines nocturnes aux espaces intérieurs bondés.
Selon les chercheurs, les approches basées sur F³ ont atteint des performances de pointe sur plusieurs tâches de perception tout en fonctionnant beaucoup plus rapidement que les méthodes précédentes.
Le système permet également d’adapter les logiciels de vision par ordinateur existants aux données des caméras d’événements, réduisant potentiellement le besoin de développer des algorithmes spécialisés pour des applications individuelles.
Les chercheurs intègrent désormais F³ dans des drones autonomes conçus pour naviguer dans des environnements encombrés et mal éclairés.
À terme, ils espèrent intégrer la technologie directement dans le matériel des caméras événementielles, permettant ainsi de convertir les signaux bruts en informations visuelles utilisables sans nécessiter de logiciel de traitement séparé.
« Notre objectif est de rendre l’utilisation d’une caméra événementielle aussi simple que celle d’une caméra conventionnelle », a déclaré Pratik Chaudhari, professeur agrégé à l’Université de Pennsylvanie.
Les chercheurs pensent que cette approche pourrait rendre les caméras événementielles plus pratiques pour les systèmes autonomes qui doivent interpréter des environnements en évolution rapide.
Les résultats ont été publiés dans la revue Robotique scientifique.
