
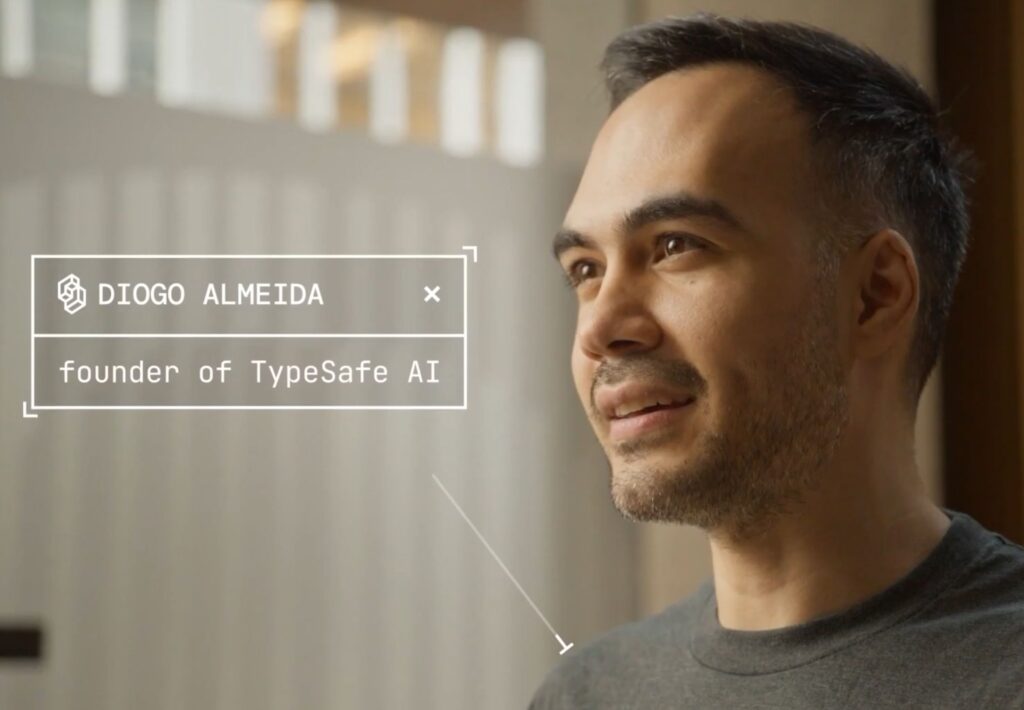
TypeSafe, fondé par un co-inventeur de ChatGPT, a quitté la discrétion et lance son modèle Jev pour automatiser les décisions programmatiques avec une architecture d’échantillonnage parallèle.
Les systèmes logiciels nécessitant une logique déterministe automatisée peuvent désormais contourner les modèles de langage conversationnel suite à la sortie par TypeSafe AI de Jev, un modèle System One spécialisé conçu pour exécuter des décisions probabilistes structurées directement dans les bases de code de production.
Développé pendant deux ans en mode furtif par le vétéran d’OpenAI et co-inventeur de ChatGPT Diogo Almeida, le modèle abandonne complètement la génération de texte et de chaînes.
Au lieu de générer de manière autorégressive des jetons de texte séquentiels, le système prend un état non structuré comme entrée et génère des valeurs structurées de type sécurisé dans une seule requête parallèle. L’architecture cible l’intégration de code déterministe, empêchant les échecs de type syntaxique et les hallucinations de sortie dès la conception.
Diogo Almeida, fondateur de TypeSafe, a déclaré : « Considérez Jev comme un appel de fonction de renseignement aux frontières : un état non structuré est entré, des décisions probabilistes saisies ont été retirées. »
Architecture du modèle Jev : fonctionnement de l’échantillonnage parallèle sensible au matériel
Les ingénieurs ont construit la plateforme autour d’une méthodologie de formation alternative appelée apprentissage par renforcement pour des décisions calibrées (RLCD).
Les modèles frontières conventionnels s’entraînent via l’apprentissage par renforcement avec retour humain (RLHF) ou l’apprentissage par renforcement avec récompenses vérifiables (RLVR) pour satisfaire les préférences conversationnelles humaines ou des contrôles programmatiques isolés. TypeSafe entraîne Jev à produire des probabilités calibrées sur la logique d’exécution, garantissant ainsi que les scores de confiance renvoyés sont directement corrélés à la précision de sortie.
S’écartant de la génération de jetons autorégressive, Jev s’appuie sur un échantillonneur parallèle sensible au matériel qui évalue et fournit simultanément toutes les valeurs structurées.
La contrainte structurelle restreint les sorties à des schémas prédéfinis, éliminant ainsi les pipelines d’analyse et les enveloppes de garde-fou requises lors du déploiement de grands modèles de langage traditionnels dans les flux d’automatisation métier. L’échantillonneur interne gère les sélections à cardinalité élevée jusqu’à 255 options discrètes, en utilisant un processus en deux étapes qui note les options indépendamment avant la sélection.
Les évaluations internes menées à partir des serveurs de l’équipe sur la côte ouest enregistrent des latences de réponse de bout en bout comprises entre 70 et 500 millisecondes, à comparer aux 3 à 329 secondes observées dans les déploiements conversationnels frontaliers.
Les évaluations de flux de travail publiées s’exécutent sur des graphiques de calcul fixes (mesurant le branchement de décision en plusieurs étapes par rapport aux lignes de base du consensus de GPT-6 Astra et Fable 5.1) ont enregistré des vitesses d’exécution jusqu’à 193,6 fois plus rapides.
Les coûts de traitement des entrées sont évalués à 0,042 $ par million de jetons, en baisse par rapport aux tarifs conversationnels standard allant de 0,20 $ à 10 $ par million de jetons. Étant donné que l’échantillonnage parallèle génère des états structurés sans passes de génération de jetons autorégressifs, TypeSafe fournit des jetons de sortie sans frais de comptage.
Des robots Doom aux pétaoctets de données : tests de déploiement Jev dans le monde réel
Les démonstrations de production montrent Jev résolvant les règles de branchement entre les états de jeu à grande vitesse et les arbres de traversée Web. Lors de tests de stress dynamiques, les ingénieurs ont exploité un robot réactif en temps réel sur les structures d’état du jeu Doom à 10 requêtes par seconde, générant des coûts d’exploitation d’environ 7 $ par heure.
Un test secondaire de Wikiracing a évalué la sélection de liens dans des répertoires d’encyclopédies denses, terminant les traversées en moins d’étapes que les modèles externes sans raisonnement en évaluant les options sans générer d’impasses hallucinées.
Les tests sur le terrain confirment les applications cibles principales à travers l’extraction de fonctionnalités en temps réel, les flux de travail de données à l’échelle du pétaoctet, les couches de vérification de sortie et la logique de branchement automatisée où les règles écrites à la main s’avèrent fragiles.
TypeSafe a ouvert aujourd’hui un accès anticipé aux développeurs et a commencé à intégrer des équipes d’ingénierie à partir de sa liste d’attente de déploiement.
